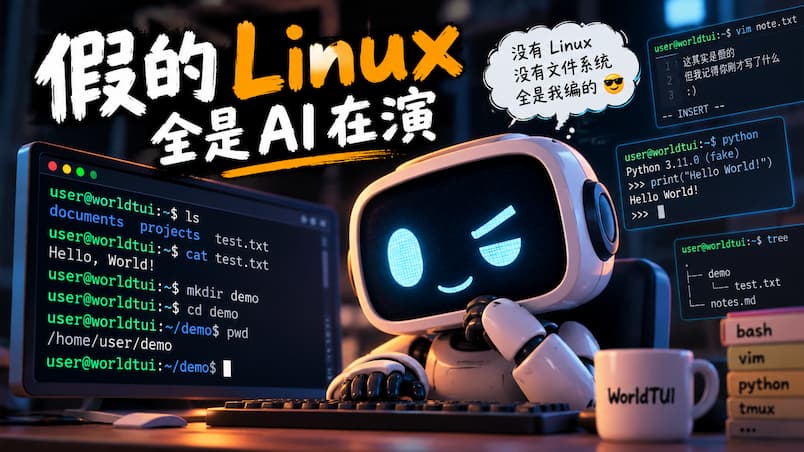
戏精,这才是戏精!
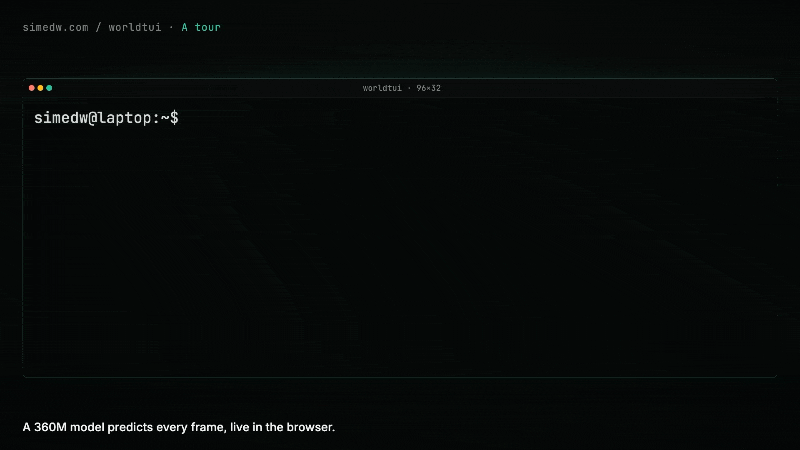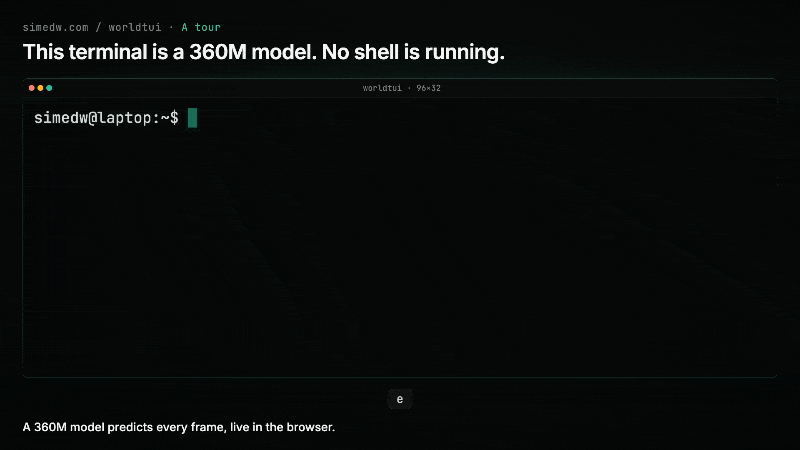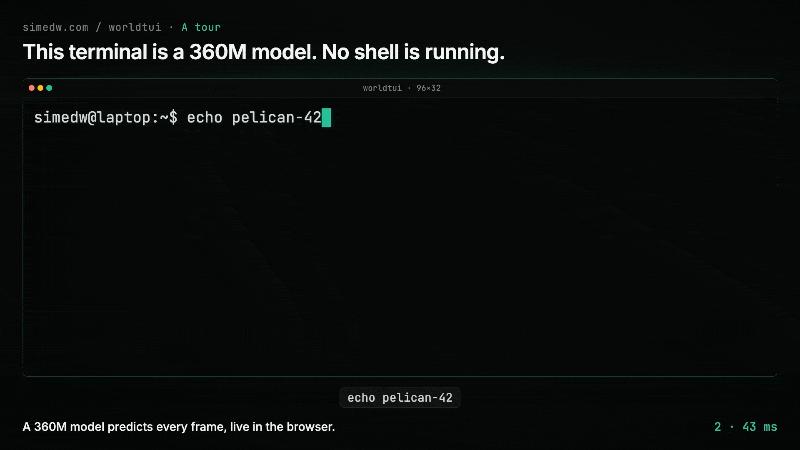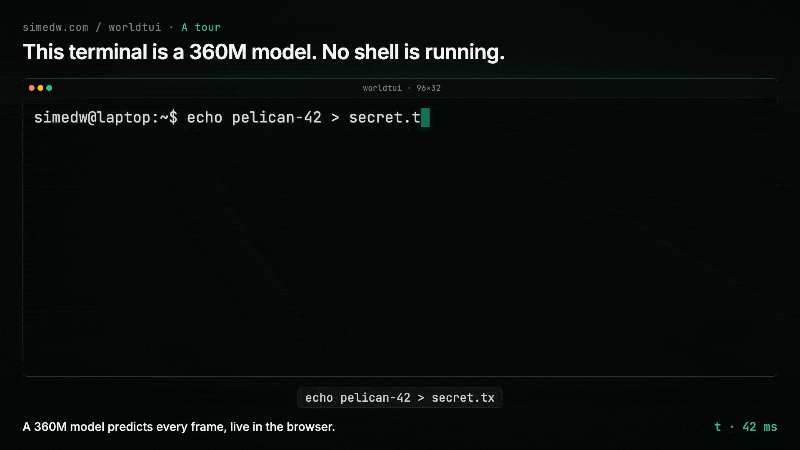
你可以在里面输入 ls、cd、mkdir,甚至打开 Vim 编辑文件、运行 Python。
看起来就像是一款普通的终端,正在接受人类的指令。
但实际上,这背后什么都没有,没有 Linux,没有文件系统,甚至没有执行命令
所有结果,都是 AI 现场编出来的 😂
一个全靠演技的终端
这个项目叫 WorldTUI,开发者 Simon Edwardsson 使用 Qwen2.5-Coder-0.5B 作为基础,训练了一个约 3.6 亿参数的小模型(716MB),量化为 int4 之后,大小只有 208 MB,轻松在本地跑起来。
它的工作方式非常有趣:
AI 只是根据你输入的命令,预测终端下一步应该显示什么。
- 你让它创建文件,它就假装创建了。
- 你让它读取文件,它就努力回忆刚才往里面写了什么。
- 你打开 Vim,它就开始扮演 Vim。
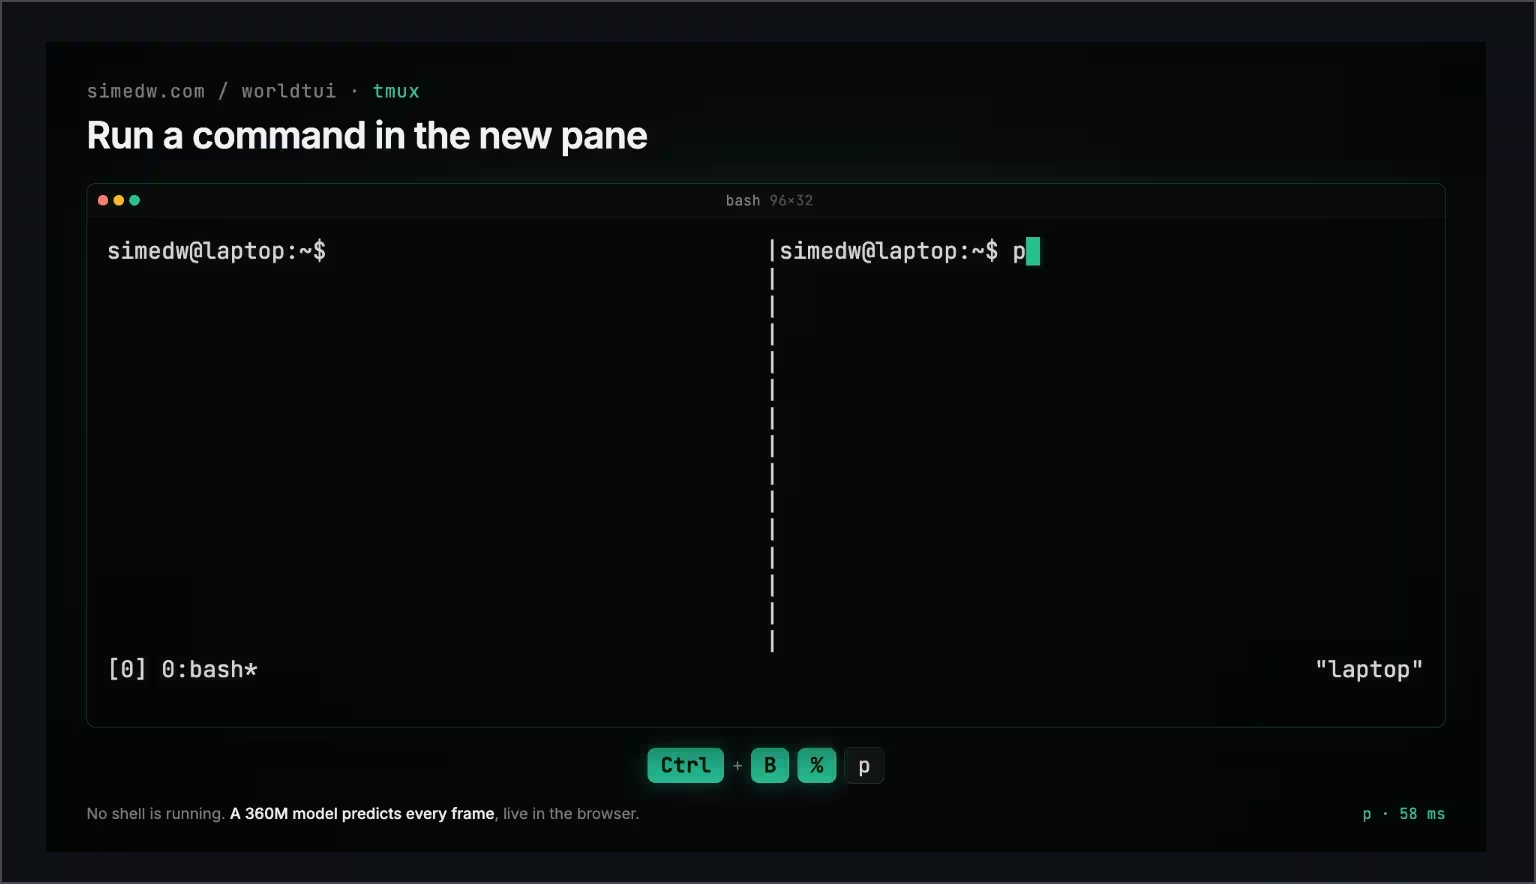
- 甚至连 Python 解释器、tmux 多窗口都能演。
主打一个:只要我演得够像,你就发现不了。
甚至可以运行 tmux:
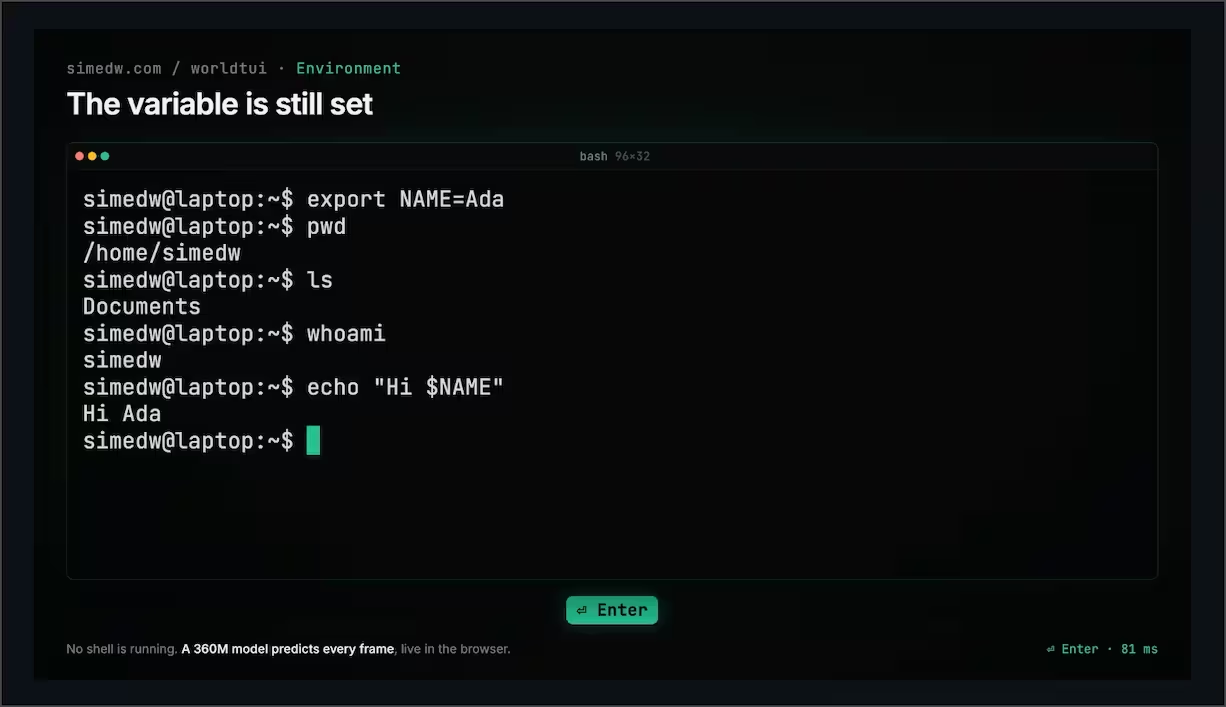
支持环境变量:
运行 Python 代码:
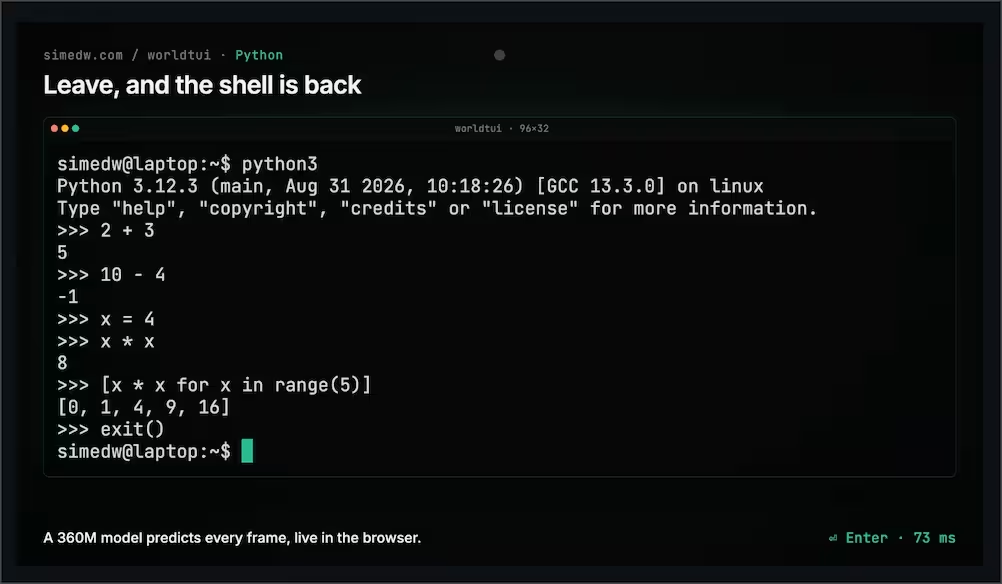
这个「戏精」居然还有记忆!
为了更逼真,这货还有记忆,你用 vim 编辑了一个文件,过一段时间,还能打开这个文件,查看到里面的内容。
不过并没有真正的文件,毕竟在演戏。
内容保存在上下文中,如果新建一个终端对话,就真没了。
他是怎么训练的?
虽然离谱,但是这个大模型是真的训练出来的。
开发者说:
- 先搭建真正的 Linux 终端。 在 Docker 容器里运行 Bash、Vim、Python、tmux 等程序,随机生成用户名、目录、文件和操作任务。
- 让脚本模拟人类操作。 一个字符一个字符地输入命令,甚至故意加入 1.2% 的打字错误,同时记录每次按键后的真实屏幕变化。
- 收集 33.6 万段操作记录。 总计约 20 亿 Token,用来微调 Qwen2.5-Coder-0.5B,让模型学习如何根据按键和历史屏幕预测下一步画面。
- 让 AI 学会自己圆谎。 如果模型预测错了,就用真实终端的结果构造纠错训练样本,让它学会修复此前的错误,减少连续操作中的穿帮。
- 优化速度,塞进浏览器。 通过并行预测终端的不同行,并缩减词表、进行 4-bit 量化,最终得到约 208MB 的模型。
训练数据
33.6 万段
训练 Token
20 亿
训练耗时
75 小时
NVIDIA RTX 4090
当然,模型也会露馅。
比如复杂命令可能执行得乱七八糟,文件内容可能突然变了,计算结果也未必正确。
毕竟,它从头到尾都没有真正执行过这些程序。
这有什么用?
觉得,虽然没什么大用。
但对于普通用户来说,这是一个极好的参考,你可以用相同的思路,让模型观察真实软件的操作过程,再训练它模仿软件的行为。
获取
在线体验需要下载约 208MB 的模型,建议使用桌面浏览器。
另外开发者说会很快公开模型权重,并提供下载链接。
原文:
最后,别入戏太深啊,这玩意是假的。