本地运行 AI 大模型的 Strata 0.2.9 发布,又变快了。
日更软件 Strata,今天更新到了 0.2.9 版本,在为本地大模型提速的道路上继续前进。
这次更新有点猛:在 Windows 系统上,使用 AMD Strix Halo 处理器运行 Qwen3.8 模型,提示词处理速度最高提升了 88%。
所谓提示词处理速度(Prefill),就是把一篇长文档、几万行代码丢给本地 AI,它读完这些内容、开始回答之前,需要等待的时间明显缩短了。
另外,这次不只有 AMD,NVIDIA、Intel 显卡也有性能优化,还新增了 Unsloth 的 1-bit DeepSeek 模型支持。
32K 长提示词,从 41 秒缩短到 22 秒(Windows + AMD Strix Halo)
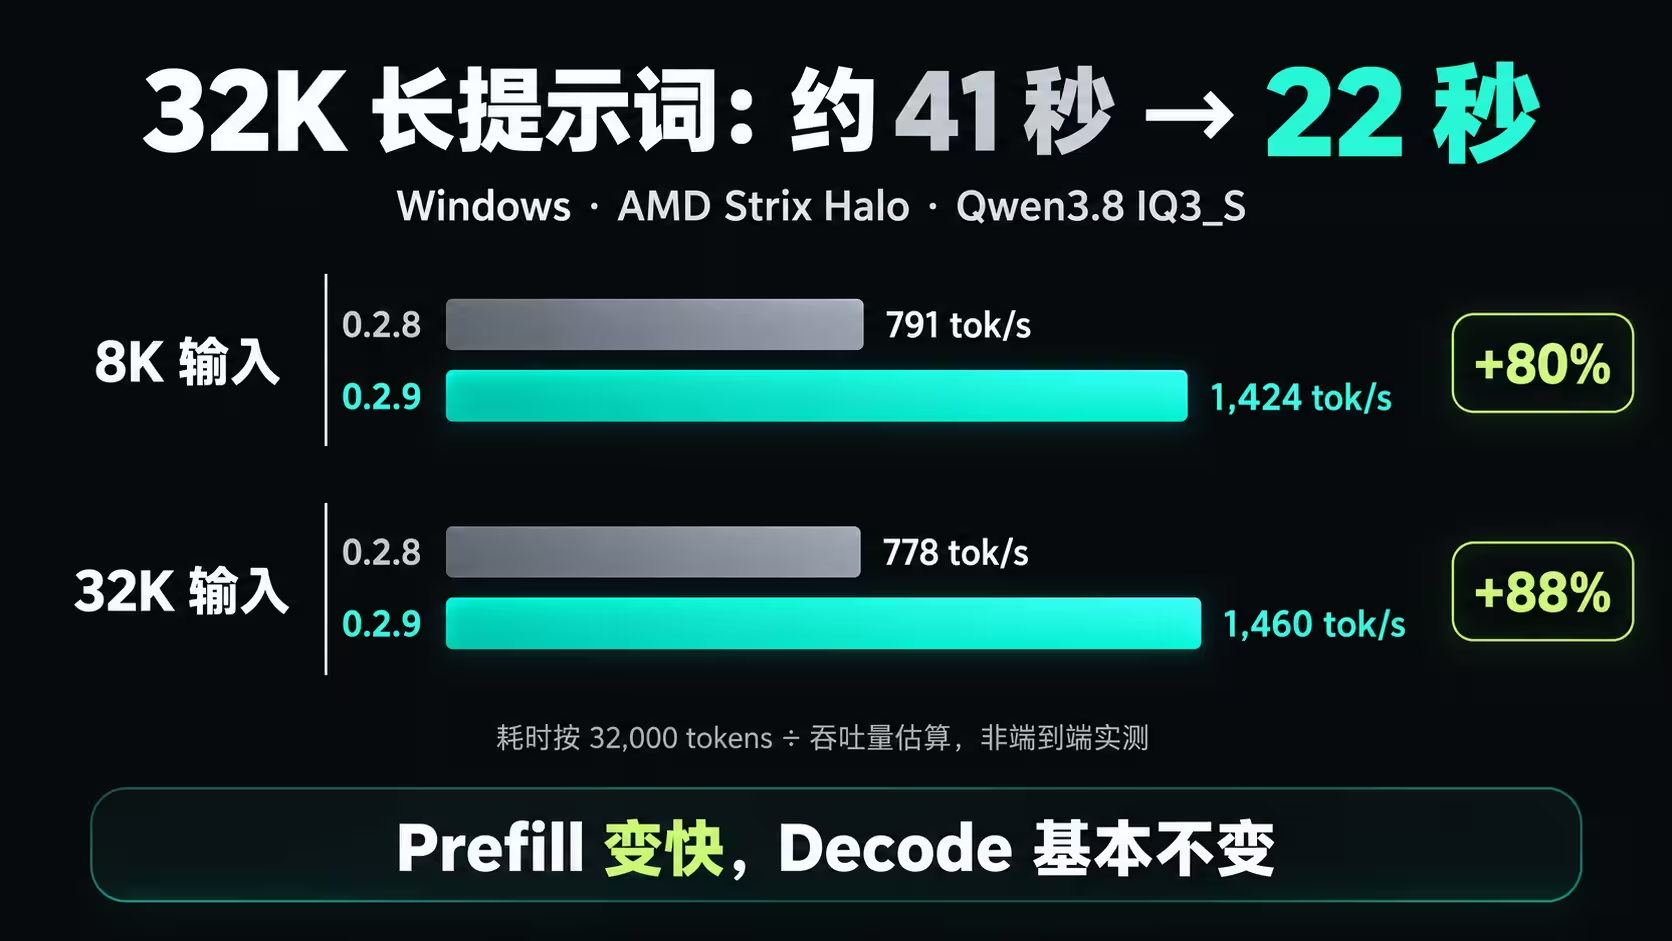
开发者使用同一台 Windows 电脑、同一个 Qwen3.8 IQ3\_S 模型,对 Strata 0.2.8 和 0.2.9 的推理引擎进行了交错测试,没有额外调整参数。
结果如下:
| 测试项目 | 0.2.8 | 0.2.9 | 提升 |
|---|---|---|---|
| Qwen3.8 IQ3\_S / 8K | 791 tok/s | 1,424 tok/s | 80% |
| Qwen3.8 IQ3\_S / 32K | 778 tok/s | 1,460 tok/s | 88% |
| Unsloth UD-IQ4\_XS / 8K | 794 tok/s | 1,243 tok/s | 57% |
| Qwen3.8 解码 | 57.4 tok/s | 58.9 tok/s | 约 3% |
其中,32K 指的是约 32,000 个 Token 的输入内容。
按测试吞吐量简单计算,处理同样长度的提示词:
- 旧版本需要约 41 秒。
- 新版本只需要约 22 秒。
一次节省约 19 秒。
如果你经常让本地 AI 阅读长文档、分析代码,或者使用 Agent 处理大量工具返回的信息,这种提升很有意义。
这次优化主要来自 AMD Strix Halo 的矩阵计算核心。Strata 默认启用了新的 F16 Matrix Core 内核,以及用于专家选择的矩阵核心计算路径。
NVIDIA 显卡也提速了,8 路并发提升 45%
开发者使用一张 RTX PRO 5000,在 Linux 下运行 Qwen3.8 IQ3\_S,在同时处理 8 个请求时,并发性能提升约 45%,单个请求的速度也提升了约 5.3%。
另外,Strata 还为 Linux 上的 NVIDIA 显卡默认启用了 Gated DeltaNet 的 Tensor Core 计算内核。
根据测试:
- RTX PRO 5000:长提示词处理提升约 4%~6%。
- RTX A4000:16K 和 32K 提示词处理分别提升 2.6% 和 3.2%。
Intel Arc 显卡也有优化
Strata 0.2.9 还继续优化了 Intel Arc B 系列显卡。
- 在两张 Intel Arc Pro B65 的测试环境中,提示词处理速度提升了 4.6%~15.8%。
- 同时处理 8 个请求时,总生成吞吐量从 42.1 tok/s 提升到了 53.8 tok/s。
另外,Strata 现在可以自动识别并使用多张 Arc 显卡,在双 B65 的短提示词测试中,使用两张显卡的处理速度达到 439 tok/s,而单卡为 221 tok/s。
不过,这些优化也有代价:通过批处理服务器处理单个请求时,解码速度反而下降了约 2.7%。
新增 1-bit DeepSeek:下载就要 241GB
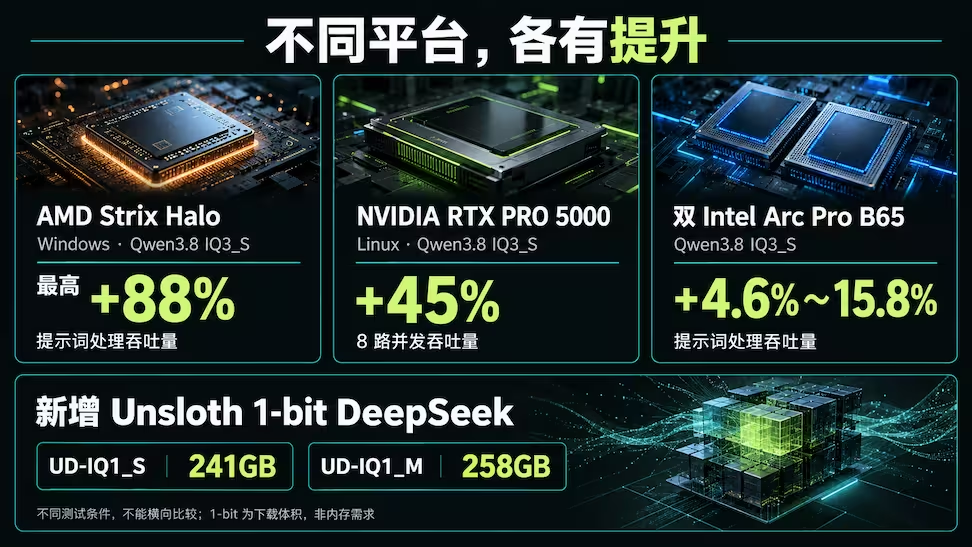
Strata 正式提供 Unsloth 的 1-bit DeepSeek 量化模型选项。
包括两个版本:
| 模型 | 下载体积 |
|---|---|
| UD-IQ1\_S | 241GB |
| UD-IQ1\_M | 258GB |
1-bit 量化的意义,普通电脑真的可以运行了,可以运行了。
开发者还提供了 61 项任务测试:
- UD-IQ1\_S:完成 53 项。
- UD-IQ1\_M:完成 53 项。
- ISTA-DAS 2.25:完成 56 项。
这个成绩略低于作为对照的 ISTA-DASLab 2.25-bit DeepSeek 量化版(56 项)。
多张 AMD 显卡终于可以自动一起工作
0.2.9 修复了多张 AMD 显卡不能同时工作的问题。
开发者使用四张 Radeon AI PRO R9700 测试 DeepSeek,更新后无需手动指定 GPU,就可以自动使用全部四张显卡。
原先默认只用一张卡时,短回答的解码速度为 7.8~25.7 tok/s。
更新后使用四张卡,六次聊天和工具调用回答的解码速度达到 57.7~103.7 tok/s。
聊天界面也变流畅了
另外 Strata 还修复了它提供的那个 Web 聊天界面,面对超长回答时,不再那么卡顿了。
在一段 40,000 Token 的模拟长回复测试中:
- 主线程耗时从 15.7 秒降至 9 秒。
- 峰值内存从 114MB 降至约 62~75MB。
此外,这次还修复了部分工具调用识别错误、Qwen3.6 预热阶段的 KV Cache 越界,以及 Windows 环境中非 UTF-8 输出导致安装或启动失败的问题。
觉得
Strata 堪称那个能让每个人都有机会 Token 自由的项目,无论如何在2026年,只要你家里还有一台电脑,都推荐试试。
它已经傻瓜到只需要双击运行就行了。
项目地址:GitHub